Stuur elk bluebarry-profiel naar een dataset in je eigen Google BigQuery-project. Je datateam kan quizantwoorden en andere opgegeven voorkeuren dan combineren met bestellingen, advertentie-uitgaven en de rest van je datawarehouse. Je hoeft geen sleutels aan te maken of te delen.
Wat er wordt gesynchroniseerd
bluebarry schrijft één rij per profiel naar een tabel met de naam bluebarry_profiles. Anders dan bij e-mailtools krijgt een datawarehouse iedereen, ook anonieme bezoekers zonder e-mailadres. Alleen profielen worden gesynchroniseerd: bestellingen en losse events zitten niet in deze tabel.
| Kolom | Bevat |
|---|---|
| id | De profiel-ID. Eén rij per persoon. |
| tenant_id | De ID van je bluebarry-workspace, dezelfde als de Tenant ID op de pagina Integrations. |
| email, phone_number | Contactgegevens, als die bekend zijn. |
| first_name, last_name | Naam, als die bekend is. |
| properties | Alle profielproperties als JSON-lijst met paren van naam en waarde: quizantwoorden, velden uit pop-upformulieren en geïmporteerde klantvelden. |
| recommendations | De laatst aanbevolen producten als JSON-lijst, met titel, link, afbeelding, prijs en de quiz die ze heeft aanbevolen. |
| consent_accepted, consent_date | Het antwoord op je vraag om marketingtoestemming en wanneer die is gegeven. |
| created_date, updated_date | Wanneer het profiel voor het eerst is gezien en voor het laatst is gewijzigd. |
| synced_at | Wanneer bluebarry de rij voor het laatst heeft geschreven. |
Je dataset voorbereiden
- Maak in BigQuery een dataset voor je bluebarry-data, of kies een bestaande. Noteer de project ID en de dataset ID.
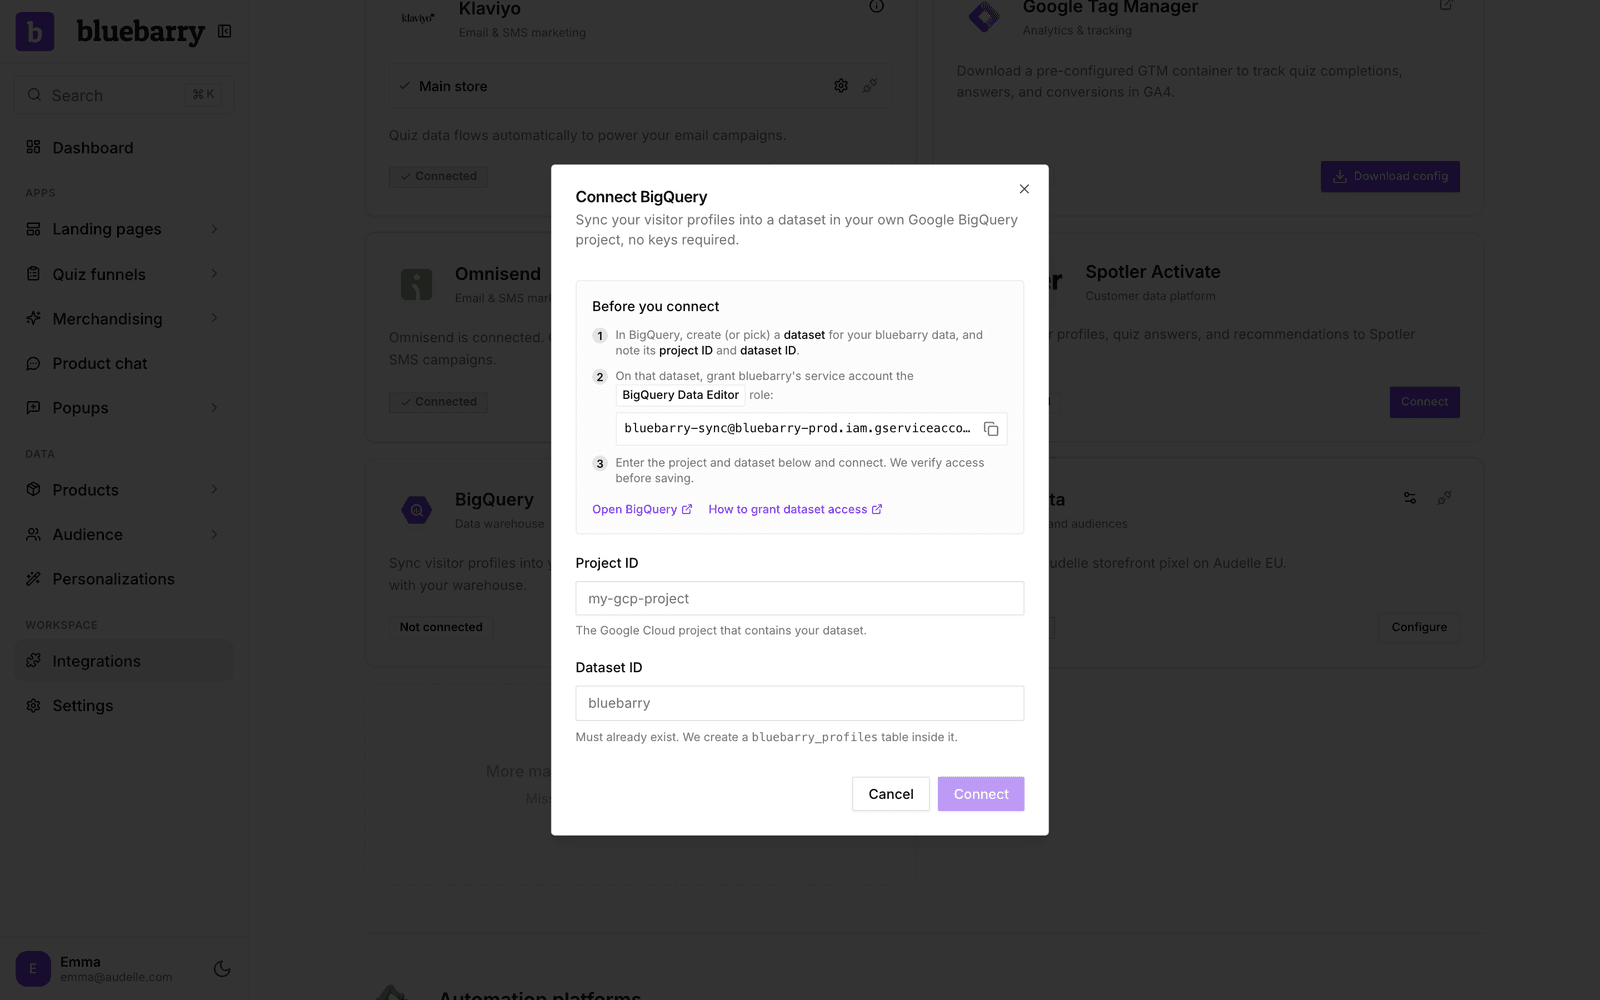
- Ga in bluebarry naar Integrations, zoek BigQuery onder Marketing & analytics en klik op Connect. Kopieer het adres van het serviceaccount dat bij stap 2 in het venster staat.
- Deel de dataset in BigQuery met dat serviceaccount en geef het de rol BigQuery Data Editor. Geef die rol alleen op de dataset, niet op het hele project.
BigQuery koppelen
- Vul in het venster Connect BigQuery de Project ID en Dataset ID in.
- Klik op Connect. bluebarry controleert of het de dataset kan bereiken voordat het opslaat. Lukt dat niet? Controleer dan de rol die je hebt gegeven en de spelling van beide ID's.
De eerste sync maakt de tabel aan en begint hem te vullen. Daarna worden gewijzigde profielen binnen ongeveer een minuut weggeschreven.
De data opvragen
Rijen worden ter plekke bijgewerkt, gematcht op id, dus de tabel bevat altijd de actuele stand van elk profiel. De kolom properties is een JSON-lijst met paren van naam en waarde. Zo lees je bijvoorbeeld een quizantwoord uit dat is opgeslagen onder de key skin_type:
SELECT email, JSON_VALUE(p, '$.value') AS skin_type
FROM `your-project.your_dataset.bluebarry_profiles`,
  UNNEST(JSON_QUERY_ARRAY(properties)) AS p
WHERE JSON_VALUE(p, '$.name') = 'skin_type'
De namen van properties zijn de keys die je op een profiel in bluebarry ziet.
Goed om te weten
- De sync-jobs draaien in het Google Cloud-project van bluebarry, dus ze tellen niet mee voor je query-quotum. De opslag van de tabel wordt aan jouw project gefactureerd, net als elke andere tabel.
- Soms zie je heel even tabellen met de naam bluebarry_profiles_stg_ gevolgd door een code. Dat zijn tijdelijke laadtabellen. bluebarry verwijdert ze meteen, en BigQuery ruimt eventuele restjes binnen zes uur op.
- De sync verwijdert nooit rijen. Anonimiseer je een klant in bluebarry, dan wordt zijn rij bij de volgende sync overschreven met het geanonimiseerde profiel.
- Koppel je later een andere dataset, dan worden daar alleen profielen naartoe geschreven die vanaf dat moment veranderen. Neem contact met ons op als je een volledige kopie in de nieuwe dataset nodig hebt.
- Haal je de rol weg, dan stopt de sync zonder waarschuwing in bluebarry. Gebruik Reconnect op de kaart om de toegang opnieuw te controleren.
Wil je zien wat er in een profiel staat voordat je het opvraagt? Zie Overzicht van profielen.