Sende jedes bluebarry-Profil an einen Datensatz in deinem eigenen Google-BigQuery-Projekt. Dein Datenteam kann dann Quizantworten und andere Angaben mit Bestellungen, Werbeausgaben und dem Rest deines Data Warehouse verknüpfen. Schlüssel musst du dafür weder anlegen noch teilen.
Was synchronisiert wird
bluebarry schreibt eine Zeile pro Profil in eine Tabelle namens bluebarry_profiles. Anders als E-Mail-Tools bekommt ein Data Warehouse alle, auch anonyme Besucher ohne E-Mail-Adresse. Synchronisiert werden nur Profile: Bestellungen und einzelne Events gehören nicht zu dieser Tabelle.
| Spalte | Inhalt |
|---|---|
| id | Die Profil-ID. Eine Zeile pro Person. |
| tenant_id | Die ID deines bluebarry-Workspace, dieselbe wie die Tenant ID auf der Seite Integrations. |
| email, phone_number | Kontaktdaten, sofern bekannt. |
| first_name, last_name | Name, sofern bekannt. |
| properties | Alle Profileigenschaften als JSON-Liste aus Name und Wert: Quizantworten, Popup-Formularfelder und importierte Kundenfelder. |
| recommendations | Die zuletzt empfohlenen Produkte als JSON-Liste, mit Titel, Link, Bild, Preis und dem Quiz, das sie empfohlen hat. |
| consent_accepted, consent_date | Die Antwort auf deine Marketing-Einwilligungsfrage und wann sie gegeben wurde. |
| created_date, updated_date | Wann das Profil zuerst gesehen und zuletzt geändert wurde. |
| synced_at | Wann bluebarry die Zeile zuletzt geschrieben hat. |
Deinen Datensatz vorbereiten
- Lege in BigQuery einen Datensatz für deine bluebarry-Daten an oder wähle einen bestehenden. Notiere seine Projekt-ID und Datensatz-ID.
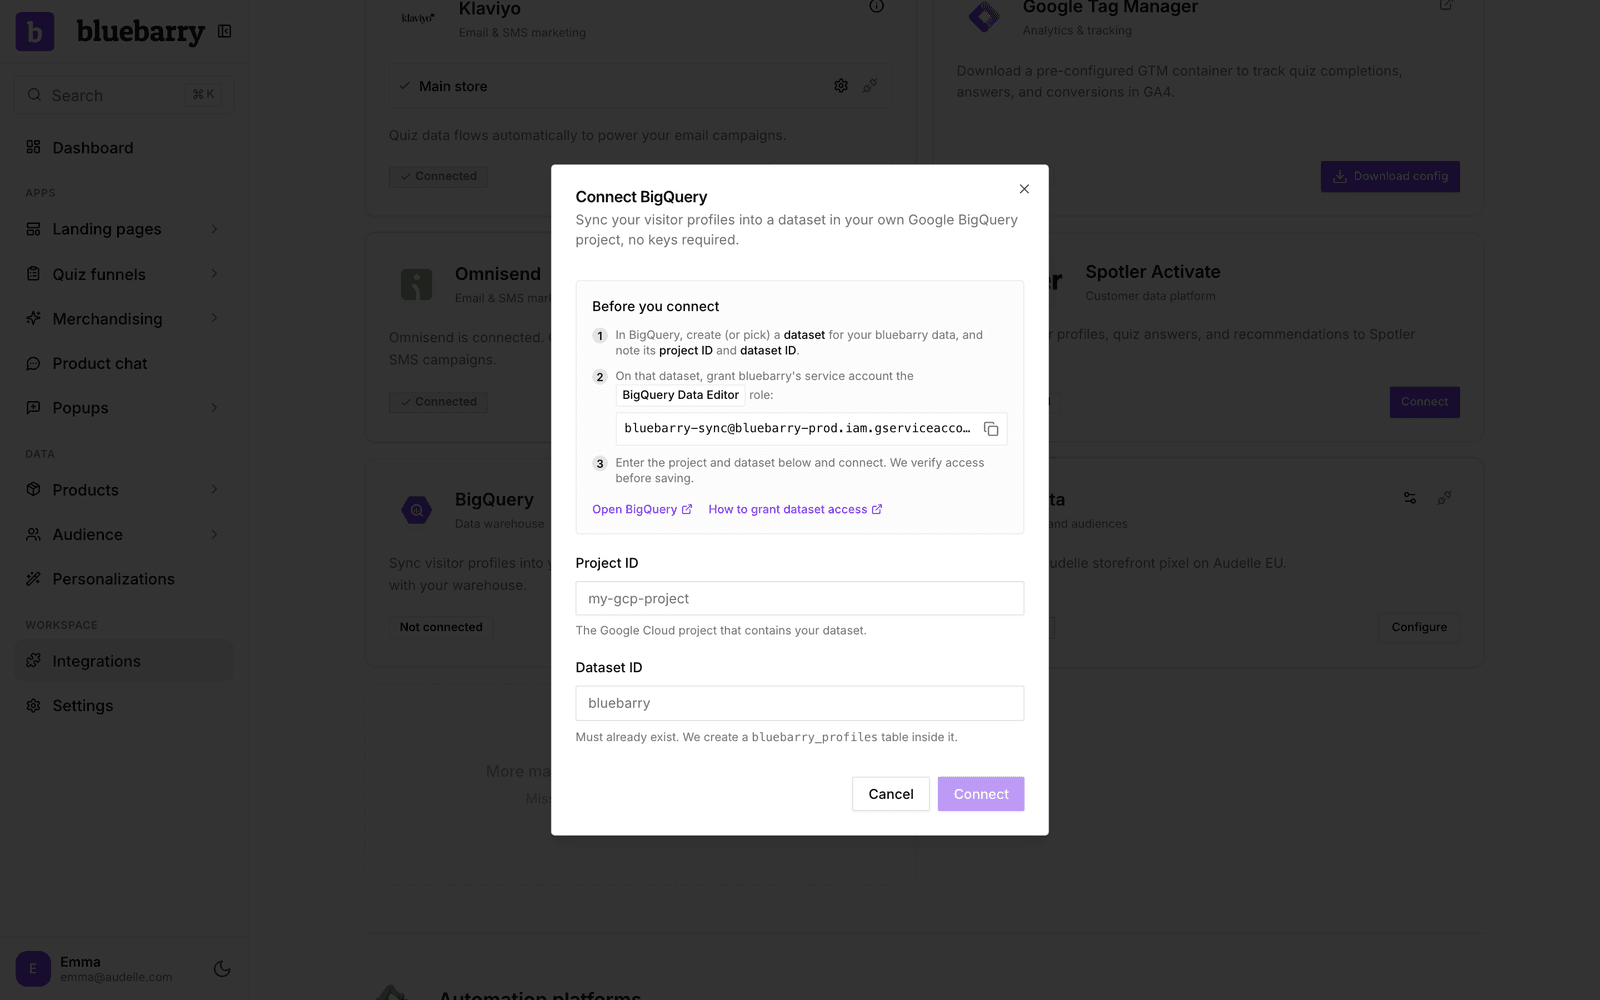
- Gehe in bluebarry zu Integrations, suche BigQuery unter Marketing & analytics und klicke auf Connect. Kopiere die Dienstkonto-Adresse aus Schritt 2 im Fenster.
- Teile den Datensatz in BigQuery mit diesem Dienstkonto und gib ihm die Rolle BigQuery Data Editor. Vergib sie nur für den Datensatz, nicht für das ganze Projekt.
BigQuery verbinden
- Gib im Fenster Connect BigQuery die Project ID und die Dataset ID ein.
- Klicke auf Connect. bluebarry prüft vor dem Speichern, ob es den Datensatz erreicht. Klappt das nicht, prüfe die vergebene Rolle und die Schreibweise beider IDs.
Die erste Synchronisierung legt die Tabelle an und beginnt, sie zu füllen. Danach werden geänderte Profile innerhalb von etwa einer Minute geschrieben.
Die Daten abfragen
Zeilen werden anhand der id überschrieben, die Tabelle zeigt also immer den aktuellen Stand jedes Profils. Die Spalte properties ist eine JSON-Liste aus Name und Wert. So liest du zum Beispiel eine Quizantwort, die unter dem Schlüssel skin_type gespeichert ist:
SELECT email, JSON_VALUE(p, '$.value') AS skin_type
FROM `your-project.your_dataset.bluebarry_profiles`,
  UNNEST(JSON_QUERY_ARRAY(properties)) AS p
WHERE JSON_VALUE(p, '$.name') = 'skin_type'
Die Namen der Eigenschaften sind die Schlüssel, die du in einem Profil in bluebarry siehst.
Gut zu wissen
- Die Sync-Jobs laufen im Google-Cloud-Projekt von bluebarry und zählen nicht gegen dein Abfragekontingent. Den Speicher der Tabelle zahlt dein Projekt, wie bei jeder anderen Tabelle.
- Kurzzeitig siehst du vielleicht Tabellen namens bluebarry_profiles_stg_ mit einem Code dahinter. Das sind temporäre Ladetabellen. bluebarry löscht sie sofort, und BigQuery entfernt Reste innerhalb von sechs Stunden.
- Die Synchronisierung löscht nie Zeilen. Anonymisierst du eine Person in bluebarry, wird ihre Zeile beim nächsten Sync mit dem anonymisierten Profil überschrieben.
- Verbindest du später einen anderen Datensatz, landen dort nur Profile, die sich ab dann ändern. Melde dich bei uns, wenn du eine vollständige Kopie im neuen Datensatz brauchst.
- Entziehst du die Rolle, stoppt die Synchronisierung ohne Hinweis in bluebarry. Mit Reconnect auf der Karte prüfst du den Zugriff erneut.
Du willst sehen, was ein Profil enthält, bevor du es abfragst? Siehe Profilübersicht.